每日简报 · 2026-11-04
信息截止:2026-11-04 08:13(北京时间)。主要覆盖 11-03 08:17 至 11-04 清晨,即美东 11-02 周一晚到 11-03 周二收盘后,以及中国的 11-03 周二。本期补入两件实际发生在 11-02、上期没有写到的事:Google 威胁情报团队的 LLMJacking 报告(11-02 发布)和 Anthropic 的 FlashProve 研究(官网署 11-02,11-03 在 X 和 TechCrunch 集中传播)。已与 10-22 至 11-03 各期对比,只写新增:Anthropic S-1/A 的财务数字 11-03 期已写,本期只取文件里此前没写的一句安全披露;苹果 Apple 智能国行版 11-01 期已写,本期只在持续追踪里更新 11-04 测试版实际上线;Kimi K3.1 Pro 开放权重截至发稿仍未出现。
一、今日判断
周二收盘后,AMD 交出数据中心收入同比增长 97% 的季报,Supermicro 单季收入接近 200 亿美元、下季指引比分析师预期高出约 3 成。一周前,半导体板块刚因为「AI 投资过热」跌了 7%;这两份财报给出的回答很直接:买芯片和整机的钱不但没停,还在加速。同一天,推理托管公司 Fal 估值翻倍到 160 亿美元,OpenAI 说 ChatGPT 的搜索量已经是 Google 的五分之一,CrowdStrike 花近 5 亿美元买两家智能体安全公司。
我的判断是:AI 的需求端已经不再需要证明自己,真正的竞争转到了「谁来管」。算力不够,Anthropic 只能高价买现货;企业的 AI 密钥被盗,一天能刷掉 10 万美元;模型被偷换,用户无从察觉。于是安全、计量和可验证性开始变成有人付钱的生意,这是本期最值得记住的变化。
一周前还在怕「AI 投资过热」,AMD 数据中心收入就同比增长 97%,Supermicro 下季指引高出预期约 3 成
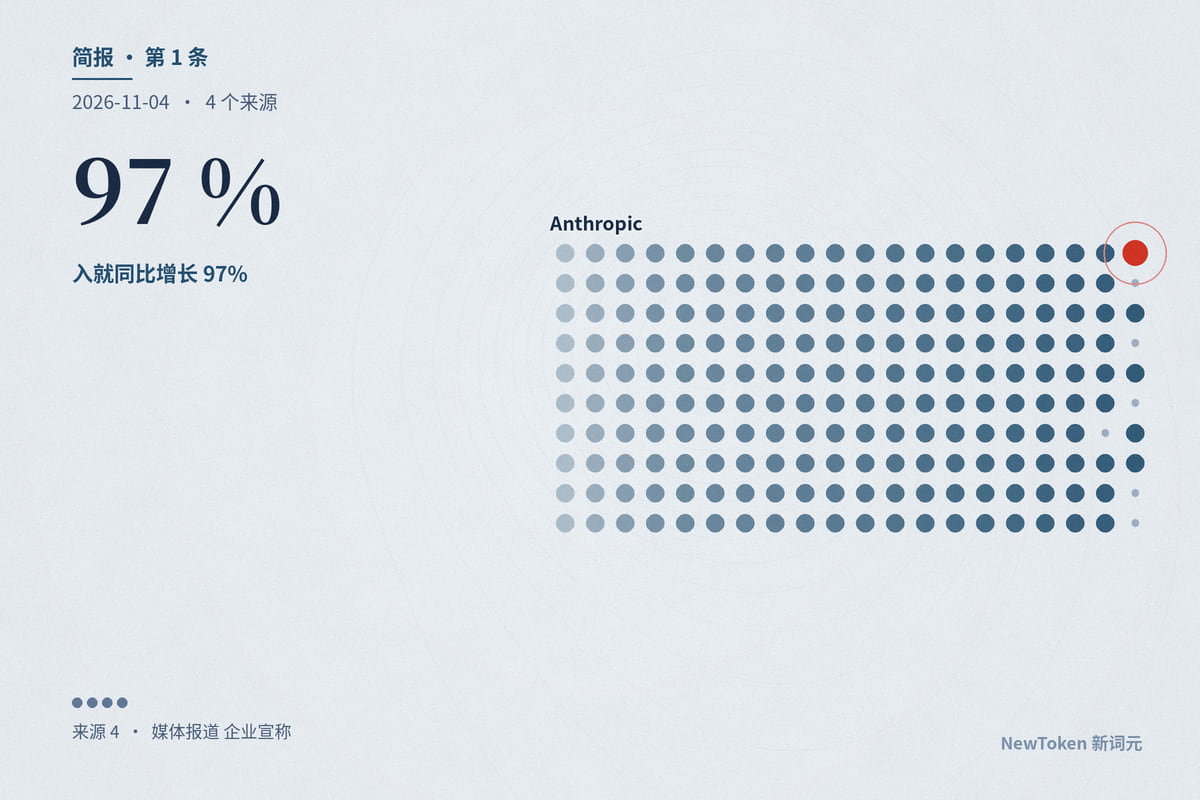
为什么重要:10-31 期我们写到费城半导体指数单日跌 7.2%、AMD 跌约 10%,市场担心 AI 基础设施投资过头。AMD 和 Supermicro 是这轮恐慌后最早交出的两份硬数字,它们给出的需求信号是加速,不是放缓。结合上期 Anthropic 披露的「50 亿美元短期高价算力」,供需两端说的是同一件事:模型公司宁愿多付钱也要拿到卡,卡和整机供应商的订单还在往上走。反方检验:Supermicro 毛利率掉到 12.7%、经营现金流为负,说明整机这一层是「量大利薄、垫资生产」的生意,收入暴涨不等于赚钱;AMD 的游戏业务同比下滑 40%,高增长高度集中在少数几家大客户身上,一旦某家放缓,波动会很大。这些风险是真实的,但它们说的是利润分配,不是需求消失。我的立场很明确:「AI 泡沫马上破」这一轮叙事被两份财报正面打回去了,接下来该问的不是有没有需求,而是这些订单的利润最后落在谁手里。
ChatGPT 的搜索量已是 Google 的五分之一,OpenAI 说广告「没有伤害产品」,还要做得更多
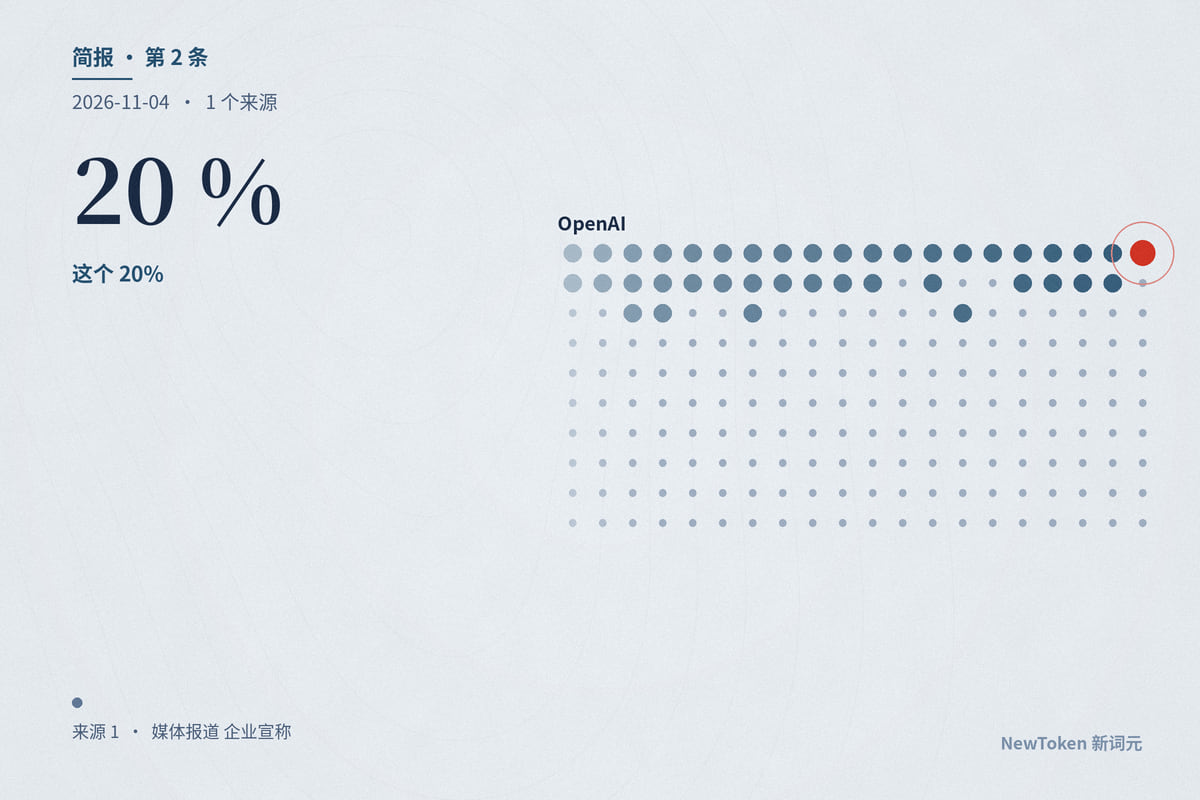
为什么重要:过去两年,「AI 会不会抢走搜索」一直停留在推测。这是 OpenAI 第一次给出一个可以和 Google 直接比较的量级。更关键的是后半句:搜索量和广告放在同一场活动里讲,说明 OpenAI 已经把 ChatGPT 当成一门广告生意来经营,而不只是订阅生意。反方检验:这个 20% 是 OpenAI 自己的口径,分母来源不明,「触发联网检索」也比 Google 意义上的一次搜索宽松;搜索量不等于广告收入,Google 的优势在于商业意图强的查询和成熟的广告主体系,ChatGPT 的搜索里有多少能变现还没有任何数据。即便如此,一个十年做不到 3% 的市场,ChatGPT 三年做到了五分之一的量。我的立场是:对内容网站和品牌方来说,「在 ChatGPT 里被看见」已经从可选项变成必选项,广告位一旦铺开,这个入口会比 Google 更封闭。
推理托管公司 Fal 半年内估值翻倍到 160 亿美元:模型越开放,「替人跑模型」越值钱
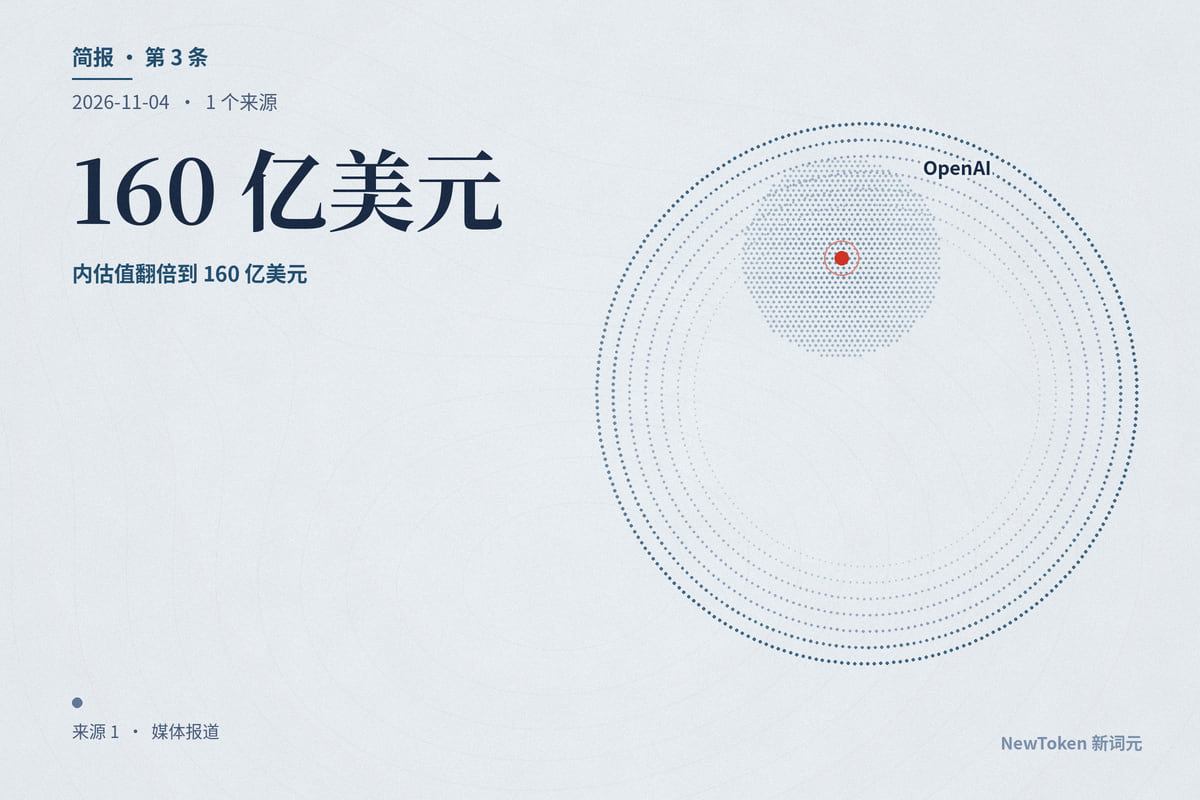
为什么重要:11-03 期写 Palantir 时我们说过,钱在往「让模型跑起来」的那一层流。Fal 是同一个信号在多媒体生成上的版本:开放权重模型越多,企业越需要有人替它们把模型部署好、跑稳、跑便宜。反方检验:薄毛利是这门生意的硬伤,推理公司夹在芯片供应商和大模型公司之间,上游涨价它吃,下游降价它也吃;如果 OpenAI、Google 直接把多媒体生成做成便宜的 API,中间层的空间会被压缩;年化收入 8 亿美元对 160 亿美元估值,市销率 20 倍,押的是继续翻倍。这些都说明它不是一门安稳的生意,但不改变方向。我的立场是:推理托管已经从「小工具」长成 AI 产业里独立的一层,开放模型生态越繁荣,这一层越大;它的天花板不由模型决定,而由能不能比云厂商更便宜地拿到算力决定。
智能体安全变成一门要花钱买的生意:CrowdStrike 近 5 亿美元收两家公司,Google 披露被盗 AI 密钥 8 小时刷掉近 100 万美元
为什么重要:企业部署智能体的速度远快于安全制度的更新,这两件事从买方和攻击方两头说明了缺口有多大。被盗的 AI 密钥和被盗的信用卡越来越像:能直接变现,而且损失按小时计。我的立场是:智能体安全正在从「合规清单上的一项」变成独立预算,CrowdStrike 这次买的不是技术,而是抢在微软、Palo Alto 之前占住「智能体的监控摄像头」这个位置。反方检验:两笔收购合计不到 5 亿美元,在安全行业属于补齐产品线的中等交易;Fiddler 成立 8 年只融了约 1 亿美元,说明这个市场此前并不热;GTIG 的报告也有为 Google 自家安全产品背书的成分。但被刷 100 万美元的账单是事故调查结果,不是营销数字。结论很直接:任何把 API 密钥写进代码仓库、不设消费上限的团队,现在就是在裸奔。
两个工程师一周用 GPT-6 Astra 做出一台设备,OpenAI 硬件团队 token 用量 9 个月涨 23 倍,但量产仍要靠人把关
为什么重要:上期我们用 GDPx 和 LifeVal 说明,AI「会跑腿、还不会拍板」。这篇文章把同一条线延伸到了实体工程:画图、出图、搭仿真这些重复劳动已经可以大量交给模型,但「这个零件能不能造出来」仍然需要懂工厂的人判断。我的立场是:AI 进入制造业的第一站不是替代工程师,而是把工程师从软件操作里解放出来,CAD 和仿真软件厂商会比工程师先感受到冲击。反方检验:这是 OpenAI 的自述,设备只是业余项目级的小样机;BenchCAD 是内部评测,新模型分数无法复现;马自达合作还没有结果,只承诺「未来几个月分享」。这些限定说明它离工厂产线还远,但 23 倍的内部用量增长说明工程师自己已经在用脚投票。
- OpenAI:加速面向物理世界的工程 企业宣称
- @OpenAI 发布帖 企业宣称
怎么证明回答你的就是那个模型:Anthropic 开源 FlashProve,同一份招股书写着「下一代模型可能很快触及加速研发门槛」
为什么重要:今天用户调用一个模型,没有任何办法确认对面真的是那个模型,第三方路由、评测机构和监管方都只能相信厂商的说法。FlashProve 第一次把这种核验的成本降到「可以想象部署」的量级,和此前同类开源系统相比快了几个数量级。把它和招股书那句话放在一起看更有意思:一家公司一边告诉投资人自己的模型可能很快开始显著加速 AI 研发,一边公开发布让外部核验「我到底在跑哪个模型」的工具,这是在为即将到来的监管提前准备证据链。反方检验:70 到 95 倍的算力开销决定了它只能事后抽查,不可能每次实时附证明;只支持 1024 token、只覆盖开放权重模型,离验证 Claude 本身还很远;「可能很快触及门槛」既是风险披露,也可能被读成对投资人的能力暗示。我的立场是:可验证推理会是 AI 监管真正能落地的技术前提,谁先把它做成行业标准,谁就在规则制定中拿到主动权,Anthropic 这一步走在了所有对手前面。
DeepSeek 下一代模型 V5 据报将主要在华为昇腾 950 上训练,产品端推出「对话造插件」的创作者模式
为什么重要:上期美团 LongCat-2.5 宣称全程国产算力训练,但没有披露芯片型号;DeepSeek 若用昇腾 950 完成下一代旗舰的预训练,就是国产芯片第一次承担国内最受关注模型的主训练任务,意义不在单个模型,而在于给整个国产训练生态定了一个标杆。反方检验:消息来自媒体援引知情人士,DeepSeek 和华为都没有确认;2027 年才可能发布,中间变数很多;国产芯片能训出来不等于训得快、训得便宜,V5 能否在能力上不掉队才是检验。但方向已经清楚了。我的立场是:在出口管制不松动的前提下,国内头部模型公司「推理先国产、训练再国产」的路线已经从选项变成了必然,DeepSeek 只是把这条路摆到了台面上。
引用与数据Markdown 镜像 · JSON · 事件 ID:evt-20261104-01、evt-20261104-02、evt-20261104-03、evt-20261104-04、evt-20261104-05、evt-20261104-06、evt-20261104-07