CloudRobo 在扰动测试里掉了 17.9 个点
华为云16日宣布开源CloudRobo-WM1.2并称双榜第一。LIBERO总体成功率81.7%,比无扰动基准低17.9个百分点。
主线模型竞争
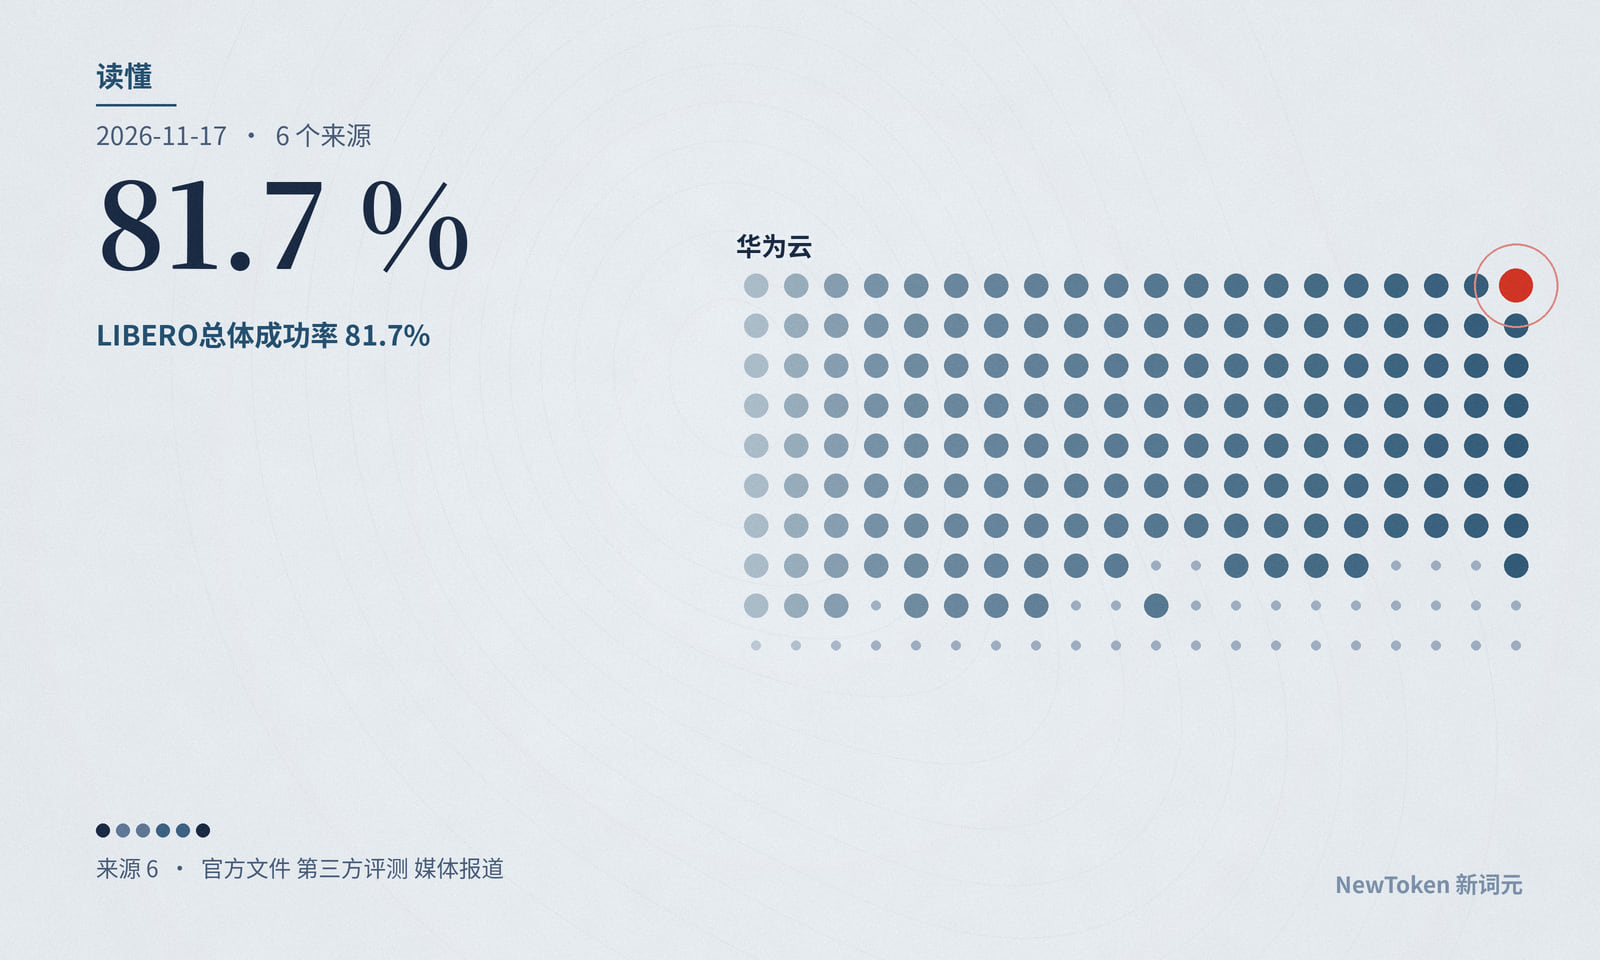
公开仿真榜上已经能核到的世界模型成绩,被写进了 11 月 16 日这场开源发布会。
据华为云发布会页面,议程在 14:50 到 14:55 写着「CloudRobo-WM1.2 世界模型正式发布暨开源」。
IT之家和通信世界网转述的发布稿,只写它在 RoboTwin 2.0、LiberoPro 2.0 评测中均位列第一,没有写出分数,也没有给出权重下载地址。
我们的判断是:双榜第一可以在公开板上核到,该带走的口径是扰动之后还剩多少。LIBERO-Pro 2.0 公开板的总体成功率是 81.7%,比无扰动基准 99.6% 低了 17.9 个百分点。发布稿里的「开源」,目前也还没有给出一份今天能打开的官方权重。
LIBERO 11 月 11 日登了提交成绩
LIBERO-Pro 2.0 公开板的更新记录写明:2026 年 11 月 11 日开始支持 CloudRobo-WM 1.2,榜上提供的是 submitted success rates(提交成绩)。
同一页的表把该模型写作 CloudRobo-WM,在 20 个模型里排第一。无扰动基准成功率 99.6%,总体 81.7%,动态干预 86.0%,静态偏移 77.8%,与基准相差 17.9 个百分点。
这是公开榜上的数字,不是发布稿里的表述。榜单自己把这组成绩标成提交成绩,我们按这个口径记录。
我们不把它抬成已经由榜主办方从零复现、并在真实作业现场核过的结果。
RoboTwin 平均到了 88.98
RoboTwin 2.0 官方榜的数据文件在 2026 年 11 月 15 日更新。更新记录写着:新增 CloudRobo-WM 的联合训练成绩,clean 条件 95.28%,randomized 条件 82.68%。
按该榜默认算法,两项平均是 88.98%,在联合训练条目里排第一。条目名称是 CloudRobo-WM,贡献者是 CloudRobo Team,列入日期是 26.11.15。该条目不要求在推理时使用观测深度。
同一份数据里还有 10 月 19 日列入的 CloudRobo-WM-Preview:clean 88.90%,randomized 75.00%,平均 81.95%。11 月 15 日这条新成绩,是在预览条目之后另列的一条。
该榜写明评测设定:在 Aloha-AgileX 上,用 50 个任务、每个任务 50 条 demo_clean 轨迹共 2500 条示范做训练,再在两种条件下各跑每任务 100 次试验。页面还写,成绩经 XPolicyLab 标准接口复现。
数据文件本身没有附上代码、权重或技术报告链接。页面的登榜规则要求公开代码、权重和技术报告。我们没有在这份数据里核到这些链接,也不把规则写成已经核对过的下载地址。
排在后面的联合训练条目里,11 月 14 日列入的 Awomo-0.6 平均 86.47%。这些都是仿真榜数字,分母是规定好的任务和试验次数。
11 月 16 日的发布稿只写了第一
华为云直播页把「正式发布暨开源」写成当天议程里的一个环节。IT之家和通信世界网转述的发布稿,把这件事说成已经发布并开源,并把两块榜的第一名写进同一句。
两家转述都介绍了五项技术,包括预测增强的世界表征、原生 DualAct 动作生成、多粒度监督预训练、跨本体运动建模,以及四种可组合的推理模式。这些是企业宣称。发布稿没有给出可核对的参数量、训练数据规模或许可证文本。
我们在 11 月 17 日打开华为云具身智能专区。页面可见的模型资产包括 CR-VLA-Dual、Lerobot-ACT、Lerobot-π₀.₅ 等,没有把 CloudRobo-WM1.2 写进这份名单。
本班在公开的 Hugging Face 检索里,也没有找到标注为 1.2 的官方权重仓库。合作伙伴渠道是否另有分发,这次没有核对。官方没有公布参数量和许可证。这两点仍是未知项。
分析推断:读者如果只读发布稿,会把「开源」理解成今天就能下载同一份登榜模型。就我们打开的官方页面和公开检索而言,这个理解还得不到支持。
第一名能核到,该看扰动后还剩多少
有人会说,RoboTwin 榜已经写明经 XPolicyLab 标准接口复现,LIBERO 也走官方评测提交,第一名就是第三方成绩,开源能不能下载不必写进同一篇。
成绩可以核,这一点成立。RoboTwin 的 95.28%、82.68% 和平均 88.98%,LIBERO 的 81.7%、86.0%、77.8% 和基准 99.6%,都出现在公开板上。发布稿只写「第一」,没有把这些分母和口径交给读者。
我们仍坚持:对要判断这套模型能不能用的人,更该先看扰动之后还剩多少。LIBERO 总体成功率比无扰动基准低 17.9 个百分点。RoboTwin 在 randomized 条件下是 82.68%,比 clean 条件的 95.28% 低 12.6 个百分点。
两块板都是仿真评测,不是真实作业现场的验收记录。发布会把已经登榜的成绩,写成一场开源发布。
第一名能核到,「开源」却还没有给出今天能打开的官方权重。要判断 CloudRobo-WM1.2 值不值得用,先看公开板上扰动后的成功率,再问权重在哪下载。现在能核到的,是仿真里的提交成绩和登榜平均分,不是一份已经放出来的模型。
来源
- 华为云 · CloudRobo具身世界模型发布会(2026-11-16 14:00–15:30) 官方文件
- IT之家 · 华为云发布并开源昇腾原生具身世界模型CloudRobo-WM1.2(2026-11-16 17:07) 媒体报道
- 通信世界网 · 华为云发布并开源昇腾原生具身世界模型CloudRobo-WM1.2(2026-11-16 17:06) 媒体报道
- RoboTwin 2.0 Leaderboard(官方榜与数据文件,2026-11-15 更新) 第三方评测
- LIBERO-Pro 2.0 Leaderboard(2026-11-17 读取) 第三方评测
- 华为云 · 具身智能专区(2026-11-17 读取) 官方文件
引用与数据Markdown 镜像