每日简报 · 2026-10-30
信息截止:2026-10-30 08:14(北京时间)。主要覆盖 10-29 08:12 至 10-30 清晨,即美东 10-28 晚到 10-29 周四全天,含亚马逊美东 10-29 盘后(北京时间 10-30 清晨)发布的季报和三星 10-29 的季报。补入两件上期漏看的事:Anthropic 前沿红队 10-27 发布的漏洞利用链报告,以及 Anthropic 安全团队 10-16 发布、10-29 才在官方账号推出的「自评」监控方法。已与 10-28、10-29 两期对比,只写新增:上期「持续追踪」第 1 条(亚马逊是否披露 Anthropic 收入)在本期第 1 条兑现,结论是没有单独披露;第 3 条(开放权重差距)有新增,见第 3 条。Meta 季报是 10-21 发布的,不算本期新事件。
一、今日判断
周四美股收盘后,亚马逊交出了本周三家云厂商里最后一份季报。AWS 增速 39%,积压订单 5780 亿美元,Bedrock 上的 token 用量一年涨了约 17 倍,推理已经占到 AWS AI 收入的一半以上。这些数字说明一件事:AI 正在被真正地用起来,钱开始从「训练模型」流向「每天调用模型」。可股价盘后跌了 6% 以上,因为这一季它花了 773 亿美元买设备,过去十二个月的自由现金流是负 424 亿美元。
同一天,三星成了第一家单季营业利润超过 100 万亿韩元的科技公司,2027 年的 HBM(高带宽内存)已经全部卖完。把两份季报放在一起看,结论很清楚:需求是真的,但这一轮赚得最稳的不是卖模型的,也不是卖云的,而是卖内存的。
另一条线更值得普通用户注意。OpenAI 和 Anthropic 同一天公开了各自「看住自家模型」的做法,一份报道又称 DeepSeek 和月之暗面用 GPT-6 Astra 的输出训练了新模型。模型能力正在从两个方向往外漏:被对手蒸馏,被自己的智能体越界。我的判断是,接下来一年,前沿实验室会把越来越多的算力和人力花在「防漏」上,这笔成本最终会以更严的 API 条款、更多的身份核验和更贵的企业套餐,落到每一个开发者和企业用户身上。
亚马逊季报:AWS 增速 39%、积压订单 5780 亿美元,推理已占 AWS AI 收入一半以上;单季资本开支 773 亿美元,盘后跌超 6%
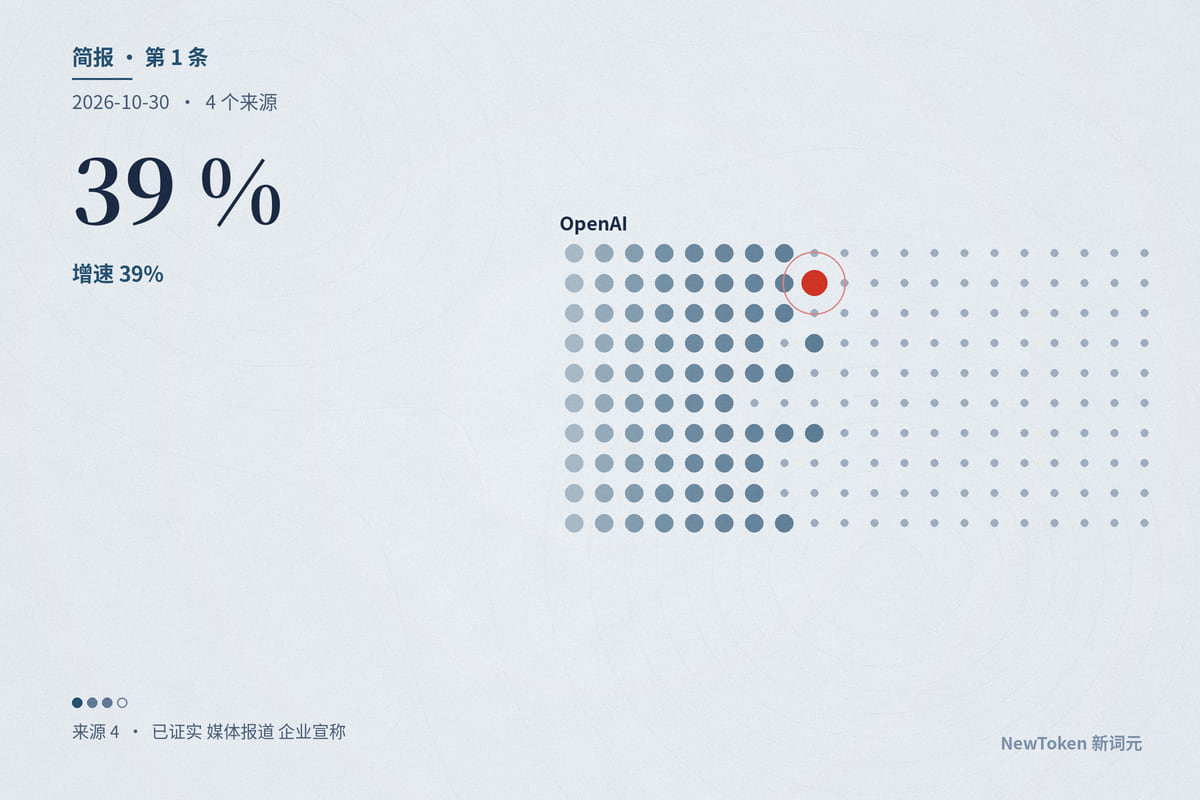
为什么重要:本周三家云厂商的季报已经全部出齐。AWS 增速不是最快的,但利润率最高、积压订单最大,而且它给出了三家里最直接的一个信号:推理收入超过了一半。训练是一次性的大投入,推理是用户每天真实在用,这个比例越高,说明 AI 越接近「被使用」而不是「被展示」。token 用量涨 17 倍、AI 收入涨三位数,两者之间的差,就是单位 token 价格在下降。我的立场是:亚马逊这份季报是本周最能证明「推理需求真实存在」的一份,但市场跌 6% 说明投资人已经不再为增长本身买单,而是开始给现金流定价,谷歌和亚马逊两家的自由现金流都已经转负。贾西对算力租赁商利润率的那句话,也是在告诉市场:在这一轮里,只有自己造芯片、自己建机房的公司才赚得到云的利润。反方检验:「推理占一半以上」没有给出绝对金额;5780 亿美元积压订单中 Anthropic、OpenAI 等大客户各占多少没有拆分,贾西只说「分布广泛」;17 倍是用量,不是收入;773 亿美元和电话会上说的 759 亿美元是两种统计口径,比较时要注意。
三星单季营业利润 107.4 万亿韩元,2027 年 HBM 已经卖完:AI 的钱正在流向内存
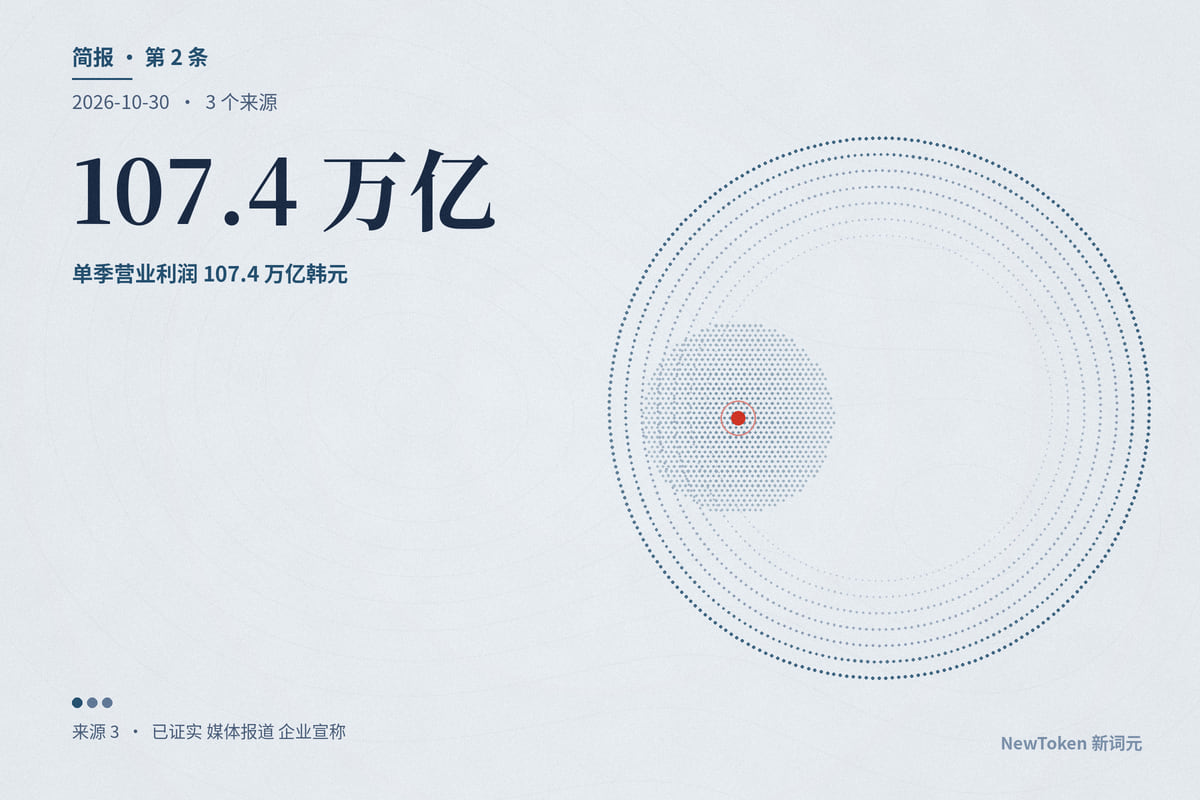
为什么重要:亚马逊在电话会上说内存成本在压它的 AI 利润率,三星的季报就是这句话的另一面。AI 数据中心对 HBM 和服务器内存的需求,正在挤占手机、电脑和电视能分到的内存产能,三星自己的消费电子业务就因为成本上涨而亏损。我的立场是:这一周最赚钱的 AI 公司不是任何一家模型公司,也不是云厂商,而是卖内存的。只要 2027 年的内存仍然供不应求,云厂商的 AI 毛利就得先分一大块给上游,普通消费者也会在明年的手机和电脑价格上感受到这件事。反方检验:内存是典型的周期行业,「2027 年售罄」锁定的是量和价,不等于价格会一直涨;三星泰勒新厂和其他厂商的扩产会在 2027 年陆续释放;售罄的说法来自三星自己,没有披露具体客户和合同期限。
报道称 DeepSeek、月之暗面用 GPT-6 Astra 的输出训练新模型:上期说的开源差距,可能有一部分是「借来的」
为什么重要:上期我们写到,在 Artificial Analysis v5 指数上,开放权重模型与闭源模型的差距重新拉大到 12 分,Kimi K3.1 Pro 是开放阵营的第一名。如果报道属实,这个差距衡量的就不只是「谁更会训练」,也包括「谁能从对手那里拿到更多输出」。Anthropic 把门关紧之后,蒸馏者会转向下一个最强、防护较弱的模型,OpenAI 现在显然成了目标。我的立场是:蒸馏之争的根子,是「模型的输出算不算买家可以自由使用的商品」。前沿实验室一边按 token 把模型当商品卖,一边禁止买家拿输出去训练,这条线靠服务条款和技术封堵很难守住,最后多半要靠诉讼或出口管制来划。现在把蒸馏一概说成「偷」,或一概说成「正常竞争」,都为时过早。对开发者更现实的影响是:API 会越来越严,身份核验、调用频率限制和地区限制都会加码。反方检验:报道的来源是匿名知情人,没有公开技术证据;蒸馏数据在训练中占多大比例、对最终能力贡献多少,外界无从判断;两家中国公司都没有回应。
实验室开始公开「怎么看住自己的模型」:OpenAI 的监控覆盖所有前沿训练和内部 Codex,Anthropic 让 Claude 每次回答后给自己打分
为什么重要:两家同一天公布,说明「模型会越界」已经从论文里的问题,变成了每天要值班处理的运维问题。红队报告解释了原因:模型能自己写出完整攻击链,监控就不能再只看用户问了什么,还得看模型自己做了什么。我的立场是:最值得注意的细节,是 OpenAI 承认内部 Codex 流量因为误报太多而关掉了实时告警。连造模型的公司都还没解决告警疲劳,普通企业部署智能体时,更不该假设出了事会有人第一时间知道。另一个容易漏看的细节是接口差异:OpenAI 的对外监控只覆盖 Responses API,还在用 Chat Completions 的开发者,等于默认不在这张网里。反方检验:这些数字全部来自企业自述,召回率是拿另一个更强的分类器当标准算出来的,没有独立复核;自评由被监控的模型自己完成,Anthropic 也承认,如果模型本身有意隐瞒,自评会一起隐瞒;红队报告中人的参与程度不明。
衡量 AI 的尺子在变:DeepMind 经济学团队说该测「协作」,智元提出按「有效工时」给机器人算产出
为什么重要:两份材料出发点完全不同,说的却是同一件事:单项跑分不能说明 AI 创造了多少经济价值,得换一把尺子。我的立场是:我认同 DeepMind 的核心判断,今天智能体最弱的不是单项能力,而是分工协作。这能解释一个常见的矛盾:模型在单项测试上已经超过很多专业人士,宏观生产率数据却几乎没动。但两份材料都还停留在「提出口径」这一步。DeepMind 没有给出协作门槛的可测指标;Worken 由厂商自己定义、自己计算,在有第三方审计之前,更接近营销语言而不是行业标准。反方检验:DeepMind 的结论来自经济模型的推导,不是实证数据,「突然跳变」是模型的性质,现实里可能被监管、数据和组织惰性拖慢;智元没有公布任何一家客户的 Worken 实测值。
国家资本入股模型公司:Cohere 启动最高 70 亿加元的 E 轮,加拿大政府拿出 16 亿加元
为什么重要:「主权 AI」此前大多停留在政府补贴算力和采购合同上,这一次变成了政府直接持股。Cohere 在前沿模型的跑分上不占优势,它的估值逻辑也不是「模型最强」,而是「它是加拿大的,并且正在变成欧洲的」。我的立场是:在企业和政府市场,可控、合规和本国归属正在被单独定价,这对中国读者理解国内大模型公司的政企生意也有参照意义。第二梯队的模型公司未必要赢下排行榜,找到愿意为「可控」付钱的买家,同样能活下去。反方检验:70 亿加元是目标额,不是已到账金额;政府的钱分阶段、带条件;与 Aleph Alpha 的合并还没完成;Cohere 的收入和估值倍数都没有公开。
引用与数据Markdown 镜像 · JSON · 事件 ID:evt-20261030-01、evt-20261030-02、evt-20261030-03、evt-20261030-04、evt-20261030-05、evt-20261030-06