千万词元上下文眼下只证明了能找到东西
新实验室 Mirendil 发布千万词元上下文模型 Fern 0.1,但在这个长度上多跳问答只答对 45%,智能体编程低于同级开放模型,也还没开放使用。
主线模型竞争
上下文长度第一次被推到一千万词元,但目前公开的证据只覆盖「在这么长的材料里找到一条信息」,没有覆盖「在这个长度上把几条信息连起来推理」,更没有覆盖「拿它干完一件活」。
我们的结论是:千万词元这个数字,眼下还不是选模型时该看的数字。它说明一家新实验室把训练和推理架构撑到了这个长度,这本身是工程成绩;但在同一张表里,能力最需要长上下文的那一项,分数是往下走的。
发生了什么
据 Mirendil 官网 10 月 26 日的发布页,这家实验室发布了第一个模型 Fern 0.1,从零预训练,上下文最长 1000 万词元,官方换算约 23MB 代码、约 50 万行,接近 Megatron-LM 代码库的规模。Fern 0.1 是底座模型 Mirendil-Base 做了一轮较短的后训练后的版本,参数规模写作 0.1 到 0.5 万亿;另外两个更大的底座还在预训练。用途写得很窄:审计训练数据、从日志里排查训练故障、把一整条智能体运行记录从头读到尾。使用方式写的是「即将开放」,目前只能申请早期访问,没有价格。
Startup Fortune 的报道补充了背景:Mirendil 成立约一年,今年 6 月带着 2 亿美元种子轮亮相,估值 10 亿美元;报道也提醒,Gemini 4 Argon 和 Claude Opus 5 的上下文是 100 万词元,Fern 的标称长度是它们的十倍。
表里真正说了什么
发布页附了一张 RULER 长上下文测试表(RULER 是英伟达研究者设计的长上下文基准)。有三处细节,决定了这张表能读出多少:
第一,测的是底座 Mirendil-Base,不是对外发布的 Fern 0.1。表注写明每格平均 100 道题,但 1000 万这一列只有 20 道。
第二,找信息的几项几乎满分:单针检索从 3.2 万到 1000 万词元一路 100%,多键检索在 1000 万处是 90%。
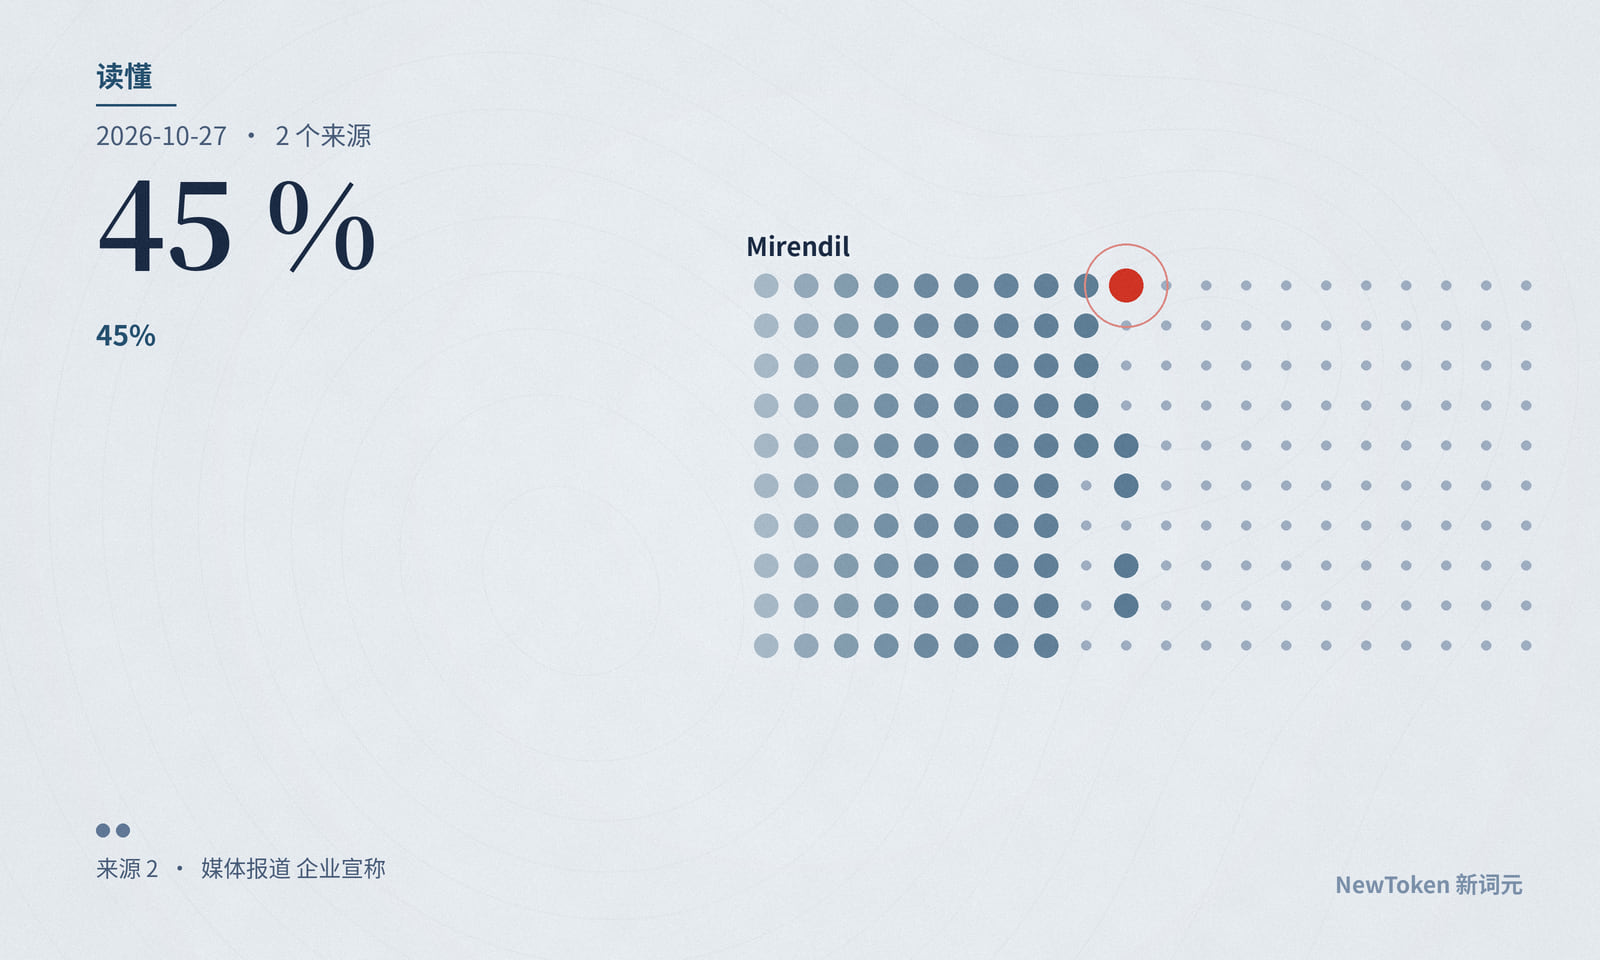
第三,需要把材料串起来想的那一项明显往下走:多跳问答(HotpotQA)在 100 万词元时是 65%,到 1000 万词元降到 45%。Startup Fortune 的报道也把这个 45% 单独拎出来,称它才是买方该拿来做计划的数字。
还有一个容易被看漏的信号:变量追踪的召回率在 400 万词元时是 75%,到 1000 万反而回到 100%。分析推断:这更像 20 道题的样本太小带来的波动,而不是越长越好;依据是同一行在 200 万、400 万处是逐级下降的,只有样本数缩到 20 的那一格反弹。
干活的分数
发布页另有一张智能体编程对比表。Fern 0.1 在 Terminal Bench 4.0 上是 6.1%,同表里开放权重的 Kimi K3 是 12.6%、GLM-5.3 是 41.9%;SWE-Bench Verified 上 Fern 是 73.4%,GLM-5.3 是 95.4%、Kimi K3 是 93.4%。Mirendil 自己的表把 Fern 放在同级开放模型后面。
这张表的口径也要拆开看。Fern 的成绩全部由 Mirendil 自己跑,用的是 OpenCode 工具、每题一次;对手的分数按表注优先取自各家模型卡,其次取基准自己的榜单或独立榜单,比如 Terminal Bench 上 Kimi K3 和 GLM-5.3 的数取自 Artificial Analysis,用的是另一套工具、三次取平均。工具和尝试次数不同,分差的精确大小不能当真,但方向是清楚的:在需要动手执行的任务上,Fern 0.1 目前不占优。
为什么重要
过去一年,上下文长度一直是发布会上的标题数字之一。Fern 把这个数字推到千万级,等于把一个问题摆到了台面上:窗口能装下,和模型能用上,是两回事。我们的看法是,判断长上下文的价值,至少要同时看三样东西:长度拉满时的多跳推理分数、在真实任务上的完成率、以及每次把一千万词元喂进去要花多少钱。Fern 目前只给了第一样里的检索部分,第三样完全没有。
分析推断:Mirendil 把用途限定在读日志、读运行记录、审计数据,恰好是「找东西」比「推理」占比更高的工作,这与它表里最强的那几项是对得上的。依据是发布页列出的六个用途里,读日志排障、读完整运行记录、审计训练数据这三个以检索和定位为主,另外三个才是写代码和改代码。
最强反方
最有力的反驳是:拿第一个版本和成熟模型比,不公平。Fern 0.1 只做了一轮短后训练,而 Kimi K3、GLM-5.3 都经过了多轮后训练,编程分数低主要反映后训练不足,不反映千万词元架构的上限;而且 Mirendil 主动公布了 45% 这个不好看的数字,说明它没有把检索分数包装成推理能力。另外,发布页的另一张图显示,在读同一个代码库时,上下文越长,Fern 预测下一个字节的误差越低,一直到约 1020 万词元仍在下降,说明多出来的上下文确实被用上了。
我们部分接受这个反驳:后训练不足确实能解释编程分数,而且公布 45% 是诚实的做法。但我们仍坚持原判断。预测误差下降说明模型从更长的材料里得到了局部的帮助,和在千万词元上做多步推理不是一回事;多跳问答从 65% 掉到 45%,测的正是后者,而它测在底座上,和后训练多少无关。所以在更多后训练版本拿出长度拉满时的推理和任务分数之前,千万词元仍应读作「能装下、能找到」。
我们不知道什么
- Fern 0.1 本身(而不是底座)在千万词元上的 RULER 分数,发布页没有给。
- 1000 万词元一次推理要多少钱、多慢:没有价格,也没有延迟数据,模型还没开放使用。
- 两个更大的模型会不会把多跳问答拉回去,目前只知道它们在预训练中。
- 所有长上下文成绩都由 Mirendil 自己测,暂时没有独立机构复现。
接下来看什么
一是早期访问开放后,有没有第三方在千万词元长度上测多跳推理和真实任务;二是 Mirendil 给不给价格,喂满一次的成本决定这个长度能不能日常用;三是下一个版本的后训练能不能把智能体编程分数拉到同级开放模型的水平。
来源
- Mirendil · Introducing Fern(2026-10-26,含 RULER 长上下文表与智能体编程对比表) 企业宣称
- Startup Fortune · Mirendil unveils Fern, an AI model claiming a 10 million token context window(2026-10-27) 媒体报道
引用与数据Markdown 镜像