英伟达调低 Vera Rubin 带宽,买家的账要重算吗?
英伟达 9 月改了 Vera Rubin 参数表,单卡显存带宽少 12.7%,10 月 29 日才解释为量产规格。按参数表估推理产出的买家要重算,已公开实测按其说法不受影响。
专题NVIDIA:持续追踪主线算力与资本
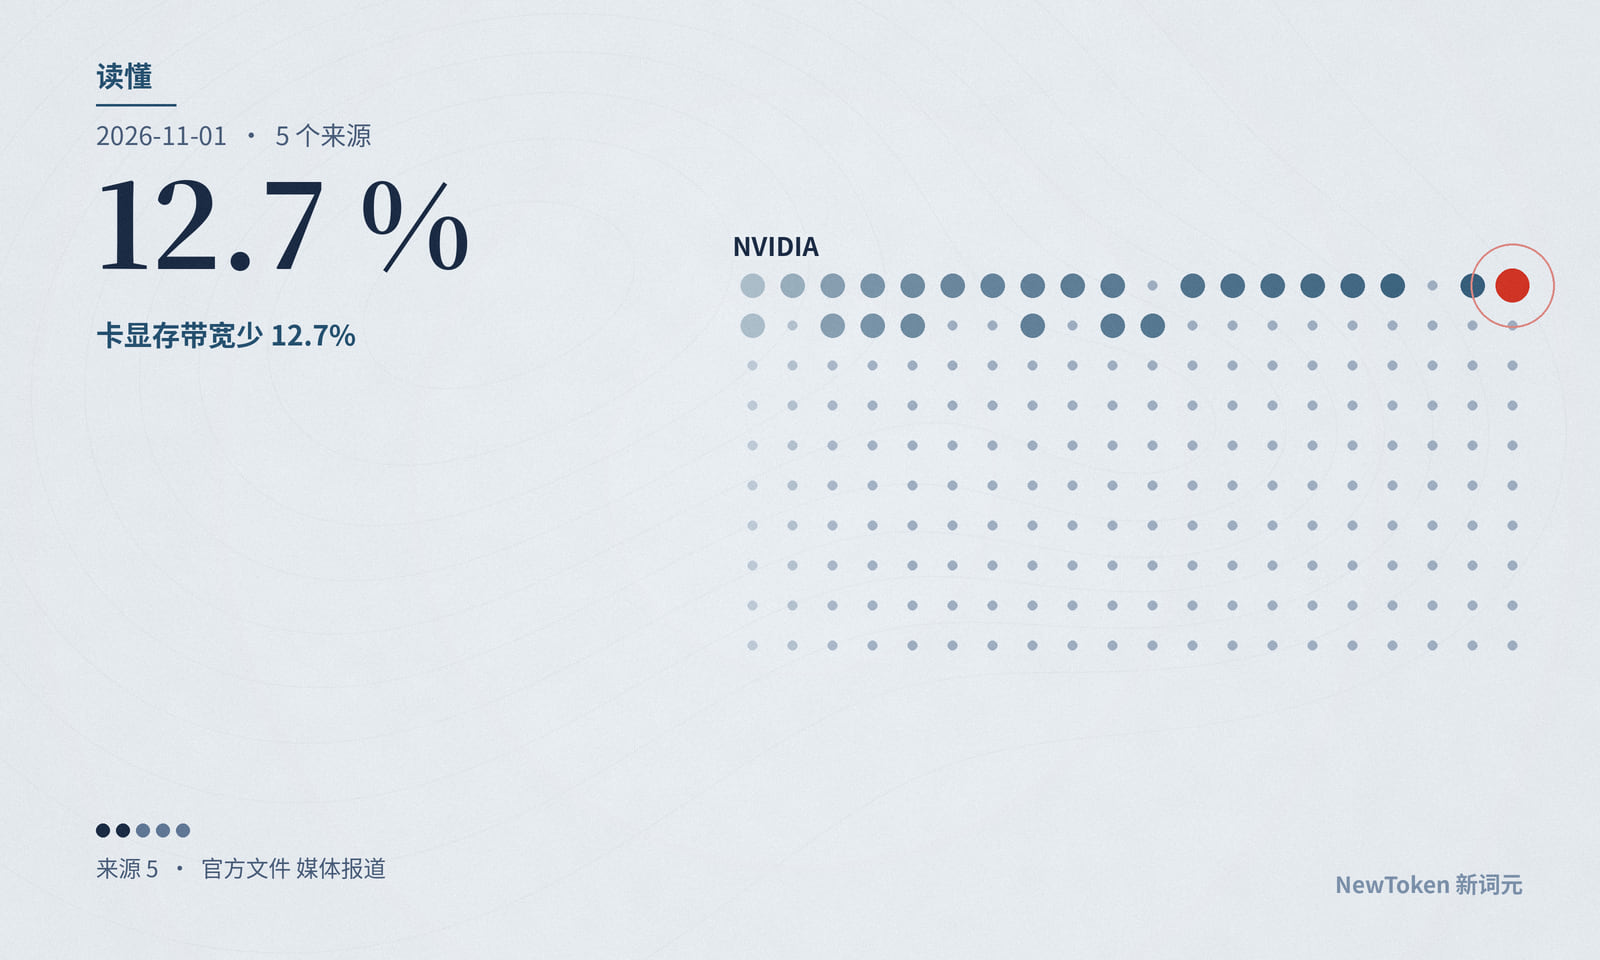
Vera Rubin 的官方参数表换了一版数字:每块 Rubin GPU 的显存带宽从 22 TB/s 改成 19.2 TB/s,少了 12.7%。买家的账要重算一部分。用参数表估算推理产出、做容量规划和回收期的人,要按新数重算;英伟达称已公开的第三方实测本来就按量产规格测,那一部分不受影响。
改动早在九月就发生了。据 Wccftech 10 月 26 日的报道,比对互联网档案馆的快照,英伟达在 9 月 1 日到 11 日之间改了产品页,没有发公告。
我们打开了 9 月 1 日的存档,旧数字与报道一致。10 月 29 日,英伟达代表对 Wccftech 解释,开发期间公布的是初步架构目标,现在的数字反映系统在合格量产下能持续达到的水平。
九月改版前后,NVL72 有四个带宽数变了
下表只列我们在英伟达官网现行页面和互联网档案馆 9 月 1 日存档里都核对过的数字:
| 项目 | 改版前/改版后 | 变化 |
|---|---|---|
| 单卡显存带宽 | 22/19.2 TB/s | 少 12.7% |
| 单卡 NVLink 带宽 | 3.6/3 TB/s | 少 16.7% |
| 整柜显存带宽 | 1,580/1,400 TB/s | 少 11.4% |
| 整柜 NVLink 带宽 | 260/216 TB/s | 少 16.9% |
没变的也要看。单卡 288 GB 的显存容量、单卡 50 PFLOPS 的 NVFP4 推理算力,两版相同。整柜对外联网带宽从 28.8 TB/s 写成了 32.4 TB/s,但新页面给这一项加了双向带宽的脚注,旧页面没有。这一项是真提升还是换了计数方法,页面上看不出来。
Wccftech 还列了 8 卡机型 HGX Rubin NVL8 的变化:总显存带宽从 176 TB/s 降到 130 TB/s,降幅 26.1%,显存容量从 2.3 TB 降到 2 TB。这一组我们没有在存档里逐项核对。
带宽少一成多,按参数表算的产出就偏高
大模型生成回答时,每产出一个词元都要把模型权重从显存读一遍。并发不高时,速度主要卡在显存带宽,而不在算力峰值。这是分析推断,依据是这类推理负载常见的瓶颈,实际影响取决于模型大小和并发量。
照这个逻辑,在带宽受限的场景里,用旧参数表估出的单卡每秒词元数会偏高,最多约高 15%(编辑据官网数字计算,22 除以 19.2)。对按词元收费的算力生意,这一项会传到收入假设和回收期里。
需要这笔账的买家正在筹钱。据 CNBC 10 月 30 日转述 Bloomberg 的报道,印度 AM Intelligence 正筹措最多 30 亿美元的债券和银行贷款,用来买 Rubin;它此前称要用 60 亿美元建 100 兆瓦算力,买 2.9 万颗 Rubin。
贷款人如果按合同租金放款,这次改版影响不大;如果按单卡产出推算收入,就要换成新数。我们看不到这些合同和贷款文件引用的是哪一版规格。
旧页面写着初步信息,英伟达的解释站得住一半
有人会说,这只是把目标值换成了量产实数。9 月 1 日的存档确实有一条脚注,写明是初步信息,所有数值为上限、可能变动。英伟达还对 Wccftech 说,单个部件的参数不决定应用性能;第三方智能体测评一直按量产规格测,结果是每美元词元数为上一代 GB300 NVL72 的 30 倍。
前半句我们接受:带脚注的目标值不能当交付承诺。后半句是企业宣称,我们没有打开那些测评逐项核对。改了参数表却不发公告,核对哪一版数字的工作就落到了买家自己身上。
如果英伟达或买家公开合同引用的规格版本,或第三方用量产机测出的单卡词元产出与旧参数推算相当,我们会修改这个判断。
来源
- 英伟达官网 · Vera Rubin NVL72 产品页(现行规格) 官方文件
- 互联网档案馆 · 英伟达 Vera Rubin NVL72 产品页 2026-09-01 存档 官方文件
- Wccftech · NVIDIA's Official Statement on Vera Rubin Spec Change(2026-10-29) 媒体报道
- Wccftech · NVIDIA Rewrote Vera Rubin's Spec Sheet Between September 1 And 11(2026-10-26) 媒体报道
- CNBC · Indian AI firm seeks to raise $3 billion to buy Nvidia chips(2026-10-30) 媒体报道
引用与数据Markdown 镜像